NVIDIA Grace Blackwell GB10 & RTX 5090 32GB • Architektura Blackwell

Prywatne środowisko AI w Twojej firmie.
Zero abonamentów. 100% kontroli nad danymi.

Dostarczamy i konfigurujemy lokalne stacje obliczeniowe z pamięcią do 128 GB oraz akceleratory RTX 5090. Przetwarzaj poufne raporty, kod źródłowy i bazy RAG wewnątrz firmowej sieci LAN bez wysyłania tokenów do chmury.

Zobacz stacje i zestawy Poznaj zakres wdrożenia RAG
Wielki kontekst & 128GB RAM

Zestawy Grace Blackwell pod Lokalne LLM

Stacja obliczeniowa + szybki magazyn Crucial X10 Pro 4TB SSD na wagi modeli i wektorowe bazy danych
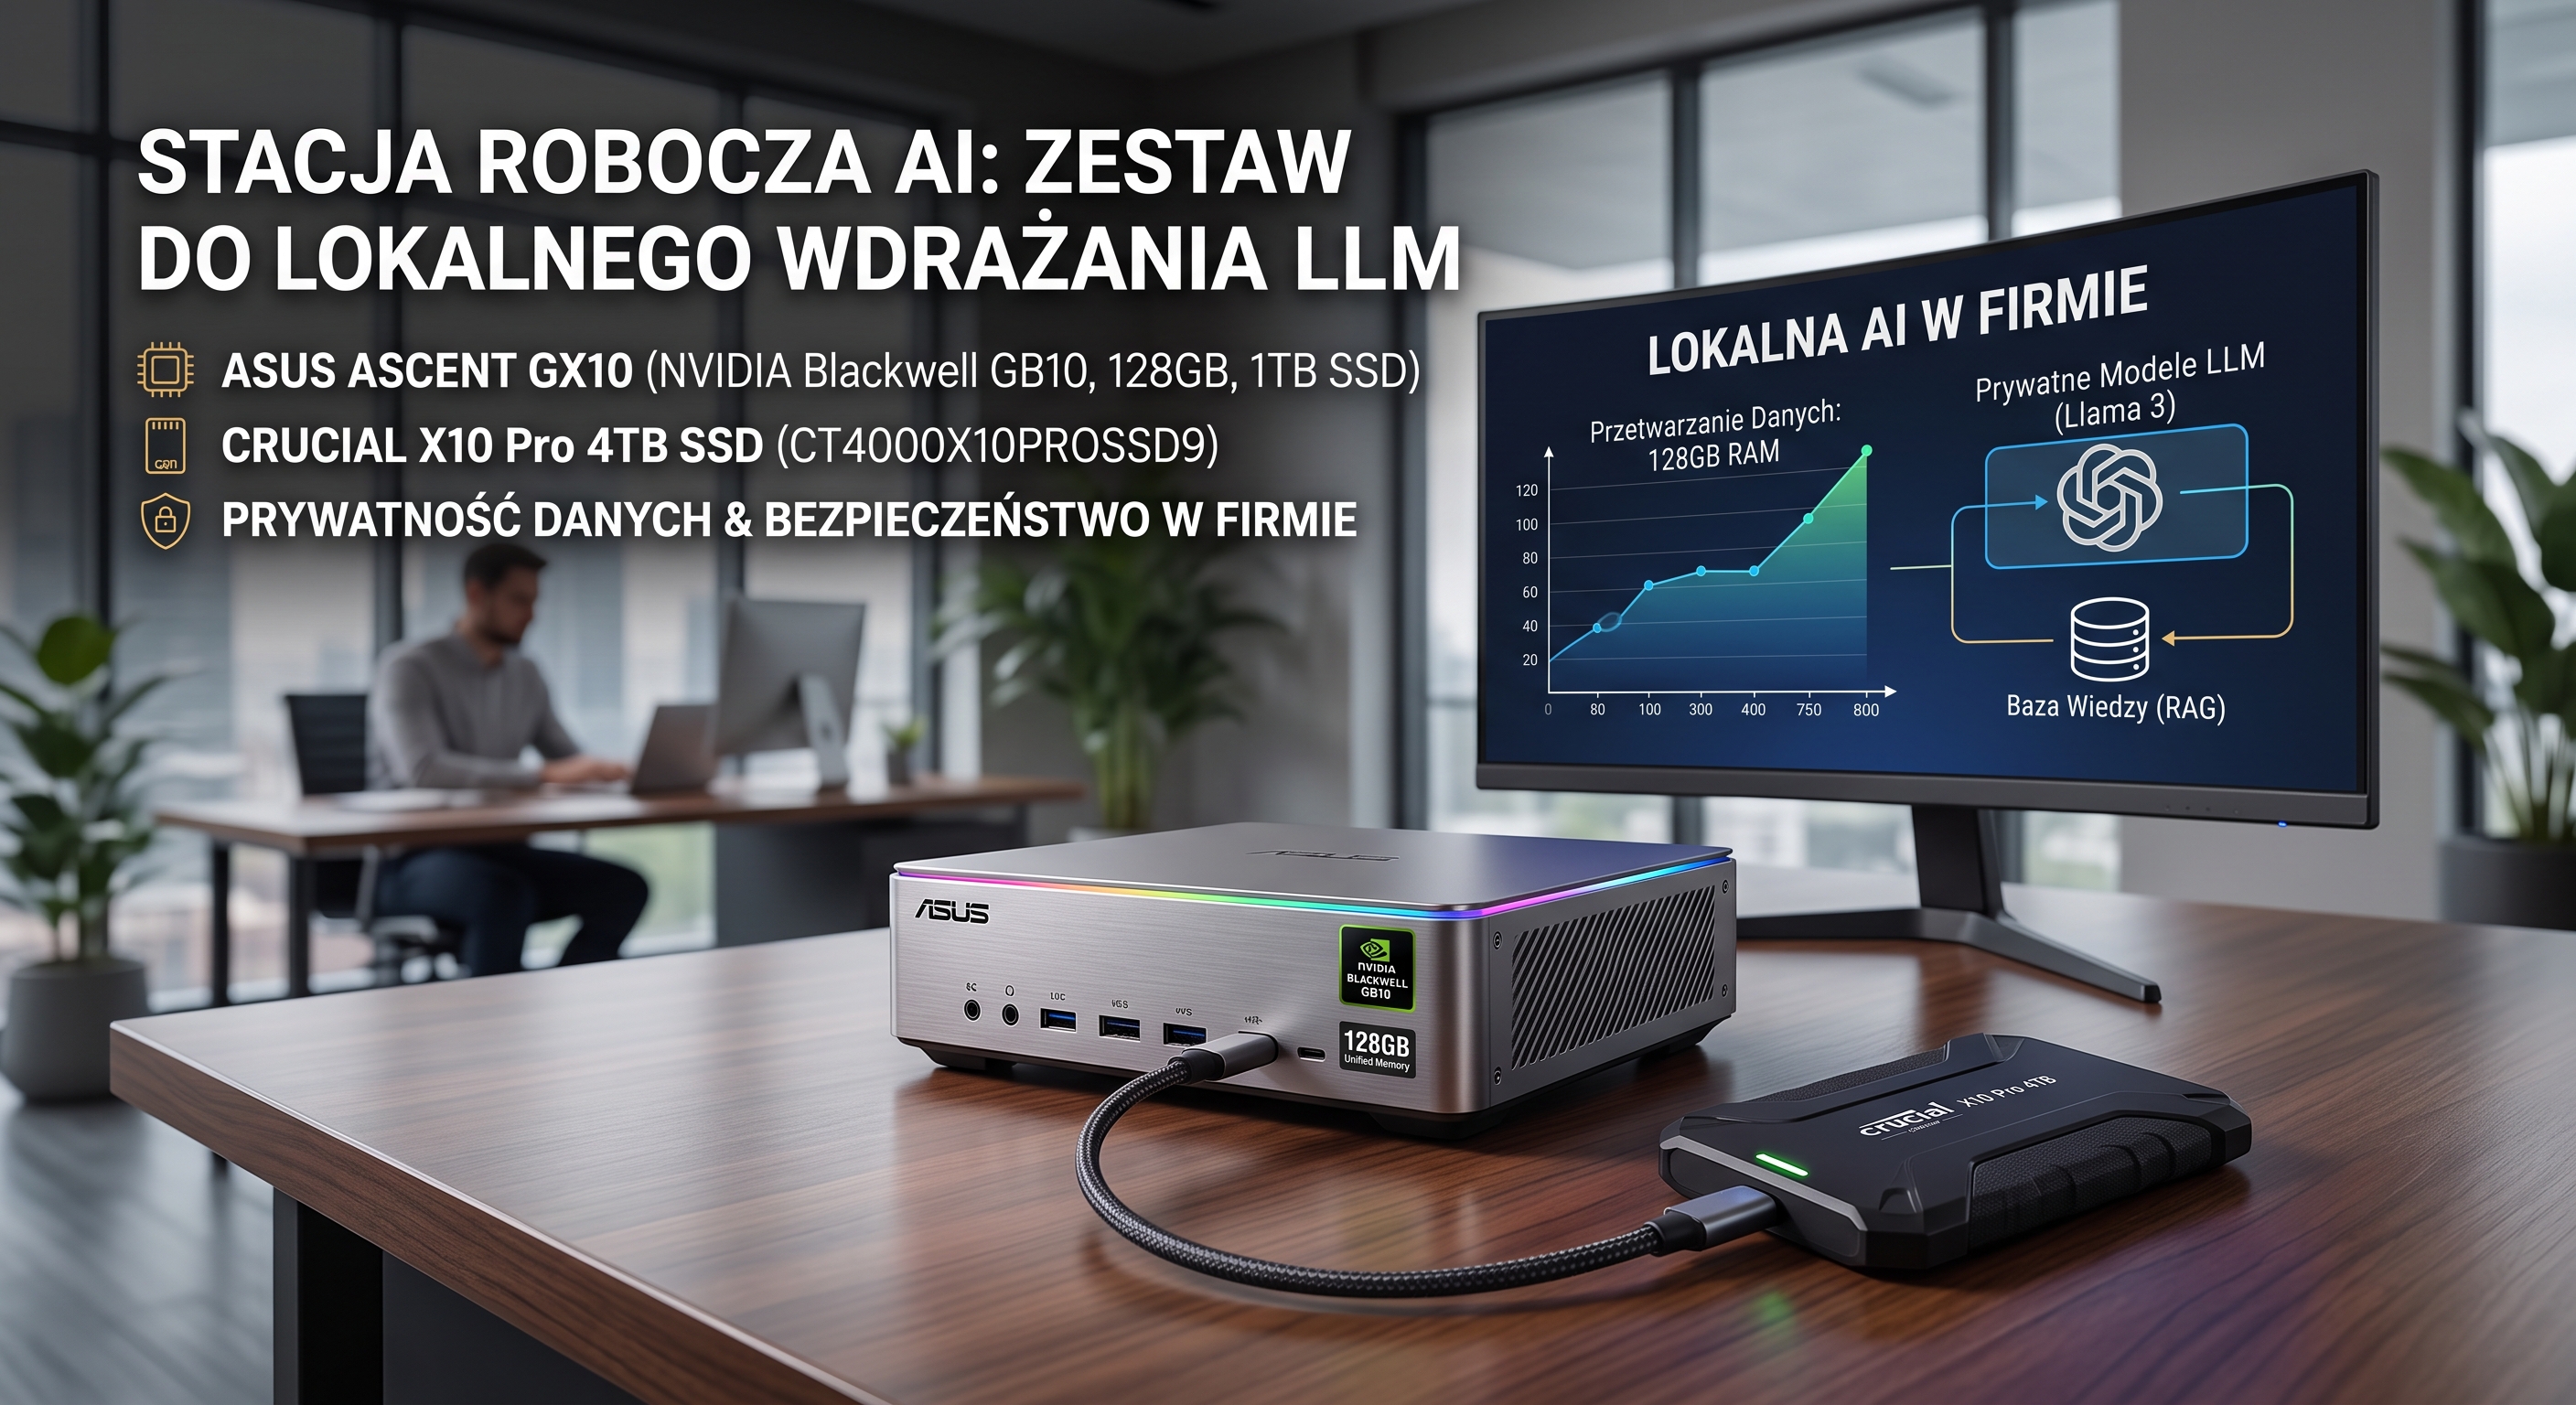
Zestaw ASUS Ascent GX10 z dyskiem 4TB
Zestaw LLM & RAG

ASUS Ascent GX10 128GB + Crucial X10 Pro 4TB

Zestaw zoptymalizowany pod szybkie wdrożenie prywatnych modeli Llama 3, DeepSeek i systemów RAG. Cicha kultura pracy, 1 PFLOP mocy obliczeniowej oraz zewnętrzny magazyn 4TB pod wagi modeli GGUF / Safetensors.

  • Układ: NVIDIA GB10 Grace Blackwell (20-core ARM)
  • Pamięć RAM: 128 GB Unified LPDDR5X (przepustowość do 273 GB/s)
  • Pamięć masowa: 1TB NVMe + 4TB Crucial X10 Pro SSD
  • System: NVIDIA DGX OS / Ubuntu Linux Enterprise
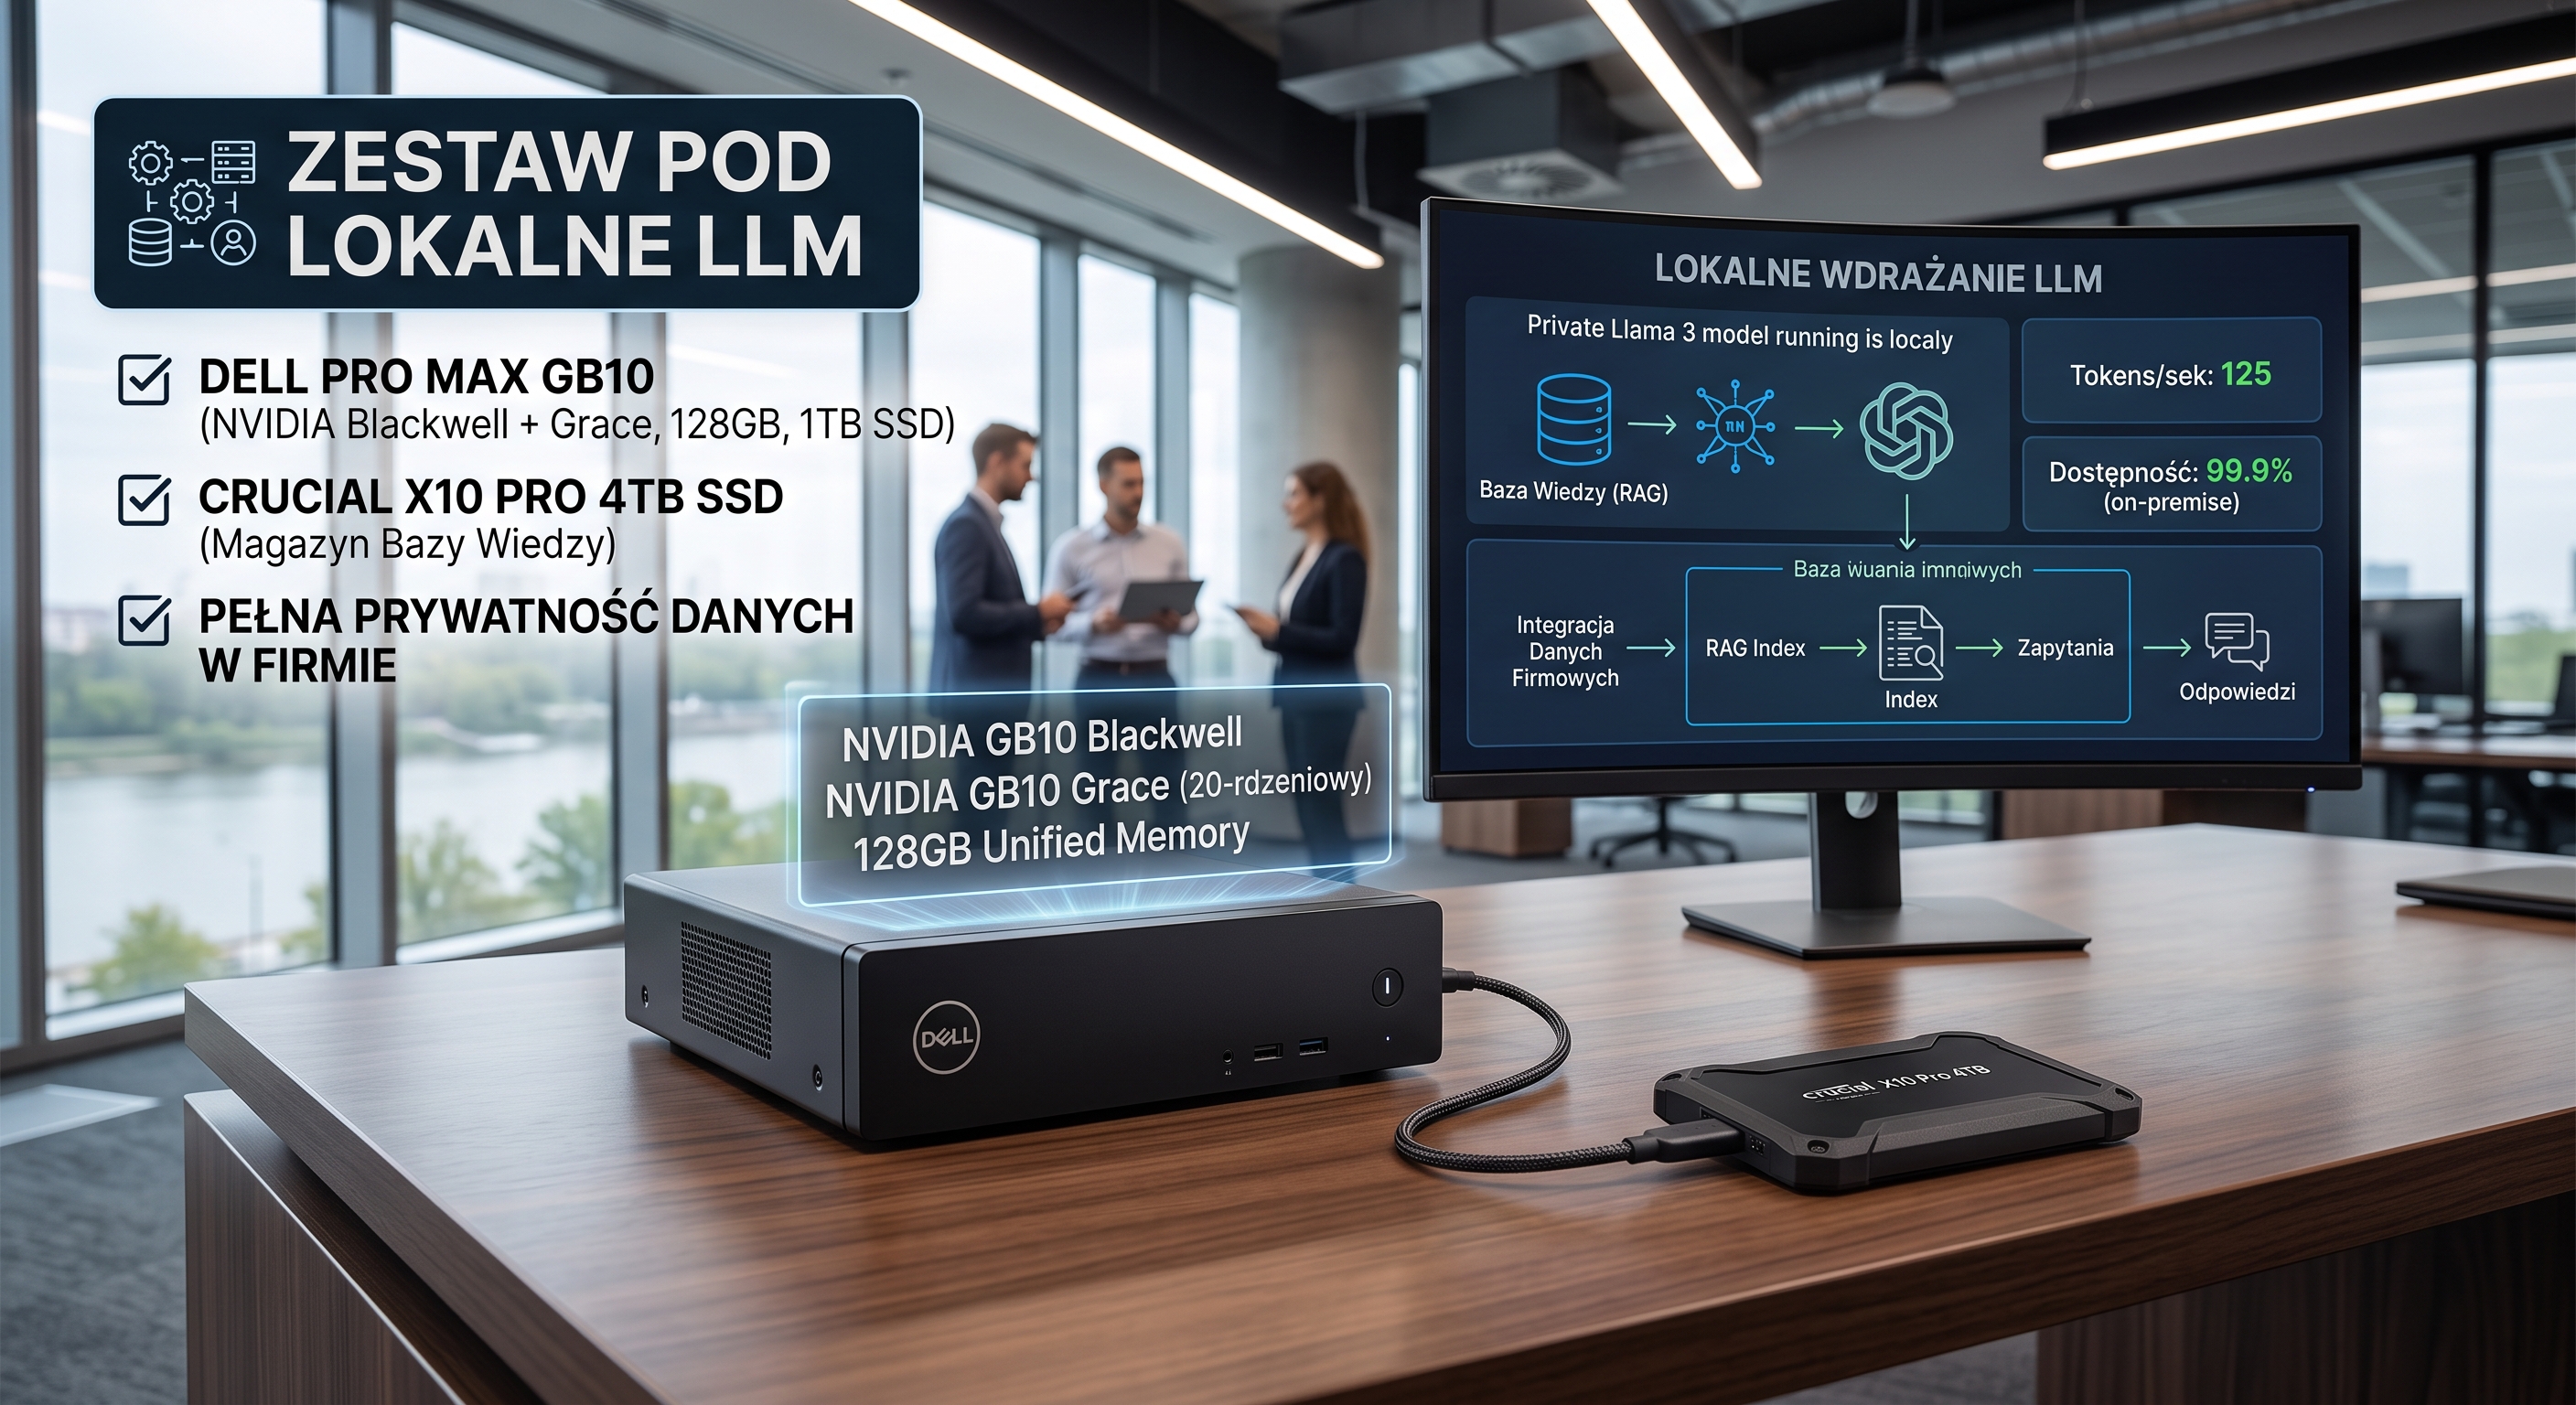
Zestaw Dell Pro Max GB10 z dyskiem 4TB
Zestaw Enterprise

Dell Pro Max FCM1253 128GB + Crucial X10 Pro 4TB

Dedykowana stacja korporacyjna z systemem NVIDIA DGX OS, gotowa do pracy w infrastrukturze klastrowej. Zapewnia sprzętowe bezpieczeństwo, certyfikację klasy enterprise oraz 4TB szybkiej przestrzeni na firmową bazę wiedzy.

  • Układ: NVIDIA GB10 Grace Blackwell (1 PFLOP AI Performance)
  • Pamięć RAM: 128 GB Unified LPDDR5X
  • Pamięć masowa: 1TB NVMe PCIe + 4TB Crucial X10 Pro SSD
  • Sieć i klastrowanie: Zgodność z NVIDIA ConnectX-7 / QSFP
Maksymalna przepustowość & Zadania ciężkie

Stacje Robocze AI: NVIDIA GeForce RTX 5090 32GB

Konfiguracje dedykowane do ultra-szybkiej inferencji (wysoki wskaźnik tokens/sec), fine-tuningu modeli (LoRA/QLoRA), zaawansowanego Vision AI oraz zadań multimodalnych.

NVIDIA RTX 5090 32GB GDDR7
Blackwell Compute Architecture
High-Throughput Pro Oferta: 18935252343

Stacja Robocza AI RTX 5090 32GB (Wariant I)

Bezkompromisowa wydajność obliczeniowa z przepustowością GDDR7. Idealna stacja pod biurko dla inżynierów Data Science, programistów wdrażających pipeline'y agentowe oraz analityków przetwarzających tysiące zapytań w czasie rzeczywistym.

  • Akcelerator: NVIDIA GeForce RTX 5090 32GB GDDR7 (512-bit)
  • Zastosowanie: Fine-tuning LoRA, Vision AI, inferencja Q4/FP8 powyżej 100 t/s
  • Architektura: Blackwell Tensor Cores piątej generacji
  • Gwarancja: Pełne wsparcie i gwarancja biznesowa B2B
NVIDIA RTX 5090 Heavy Compute
Extreme Workstation Platform
Heavy Compute Pro Oferta: 18935264734

Stacja Robocza AI RTX 5090 32GB (Wariant II)

Rozszerzona konfiguracja stacji obliczeniowej stworzona do intensywnych obciążeń ciągłych 24/7, wielowątkowego przetwarzania dokumentacji PDF w trybie batch oraz generatywnych modeli graficznych i wideo (ComfyUI / Diffusion).

  • Akcelerator: NVIDIA GeForce RTX 5090 32GB GDDR7
  • Pamięć i Storage: Rozszerzony podsystem RAM i ultraszybkie dyski Gen5 NVMe
  • Chłodzenie: Przystosowane do wielogodzinnej inferencji pod 100% obciążenia
  • Faktura i leasing: Faktura VAT 23% dla firm z protokołem odbioru
Wersje podstawowe

Stacje Bazowe GB10 (Bez dysku zewnętrznego)

Dla zespołów posiadających własne zasoby pamięci masowej (NAS / SAN / macierze NVMe)

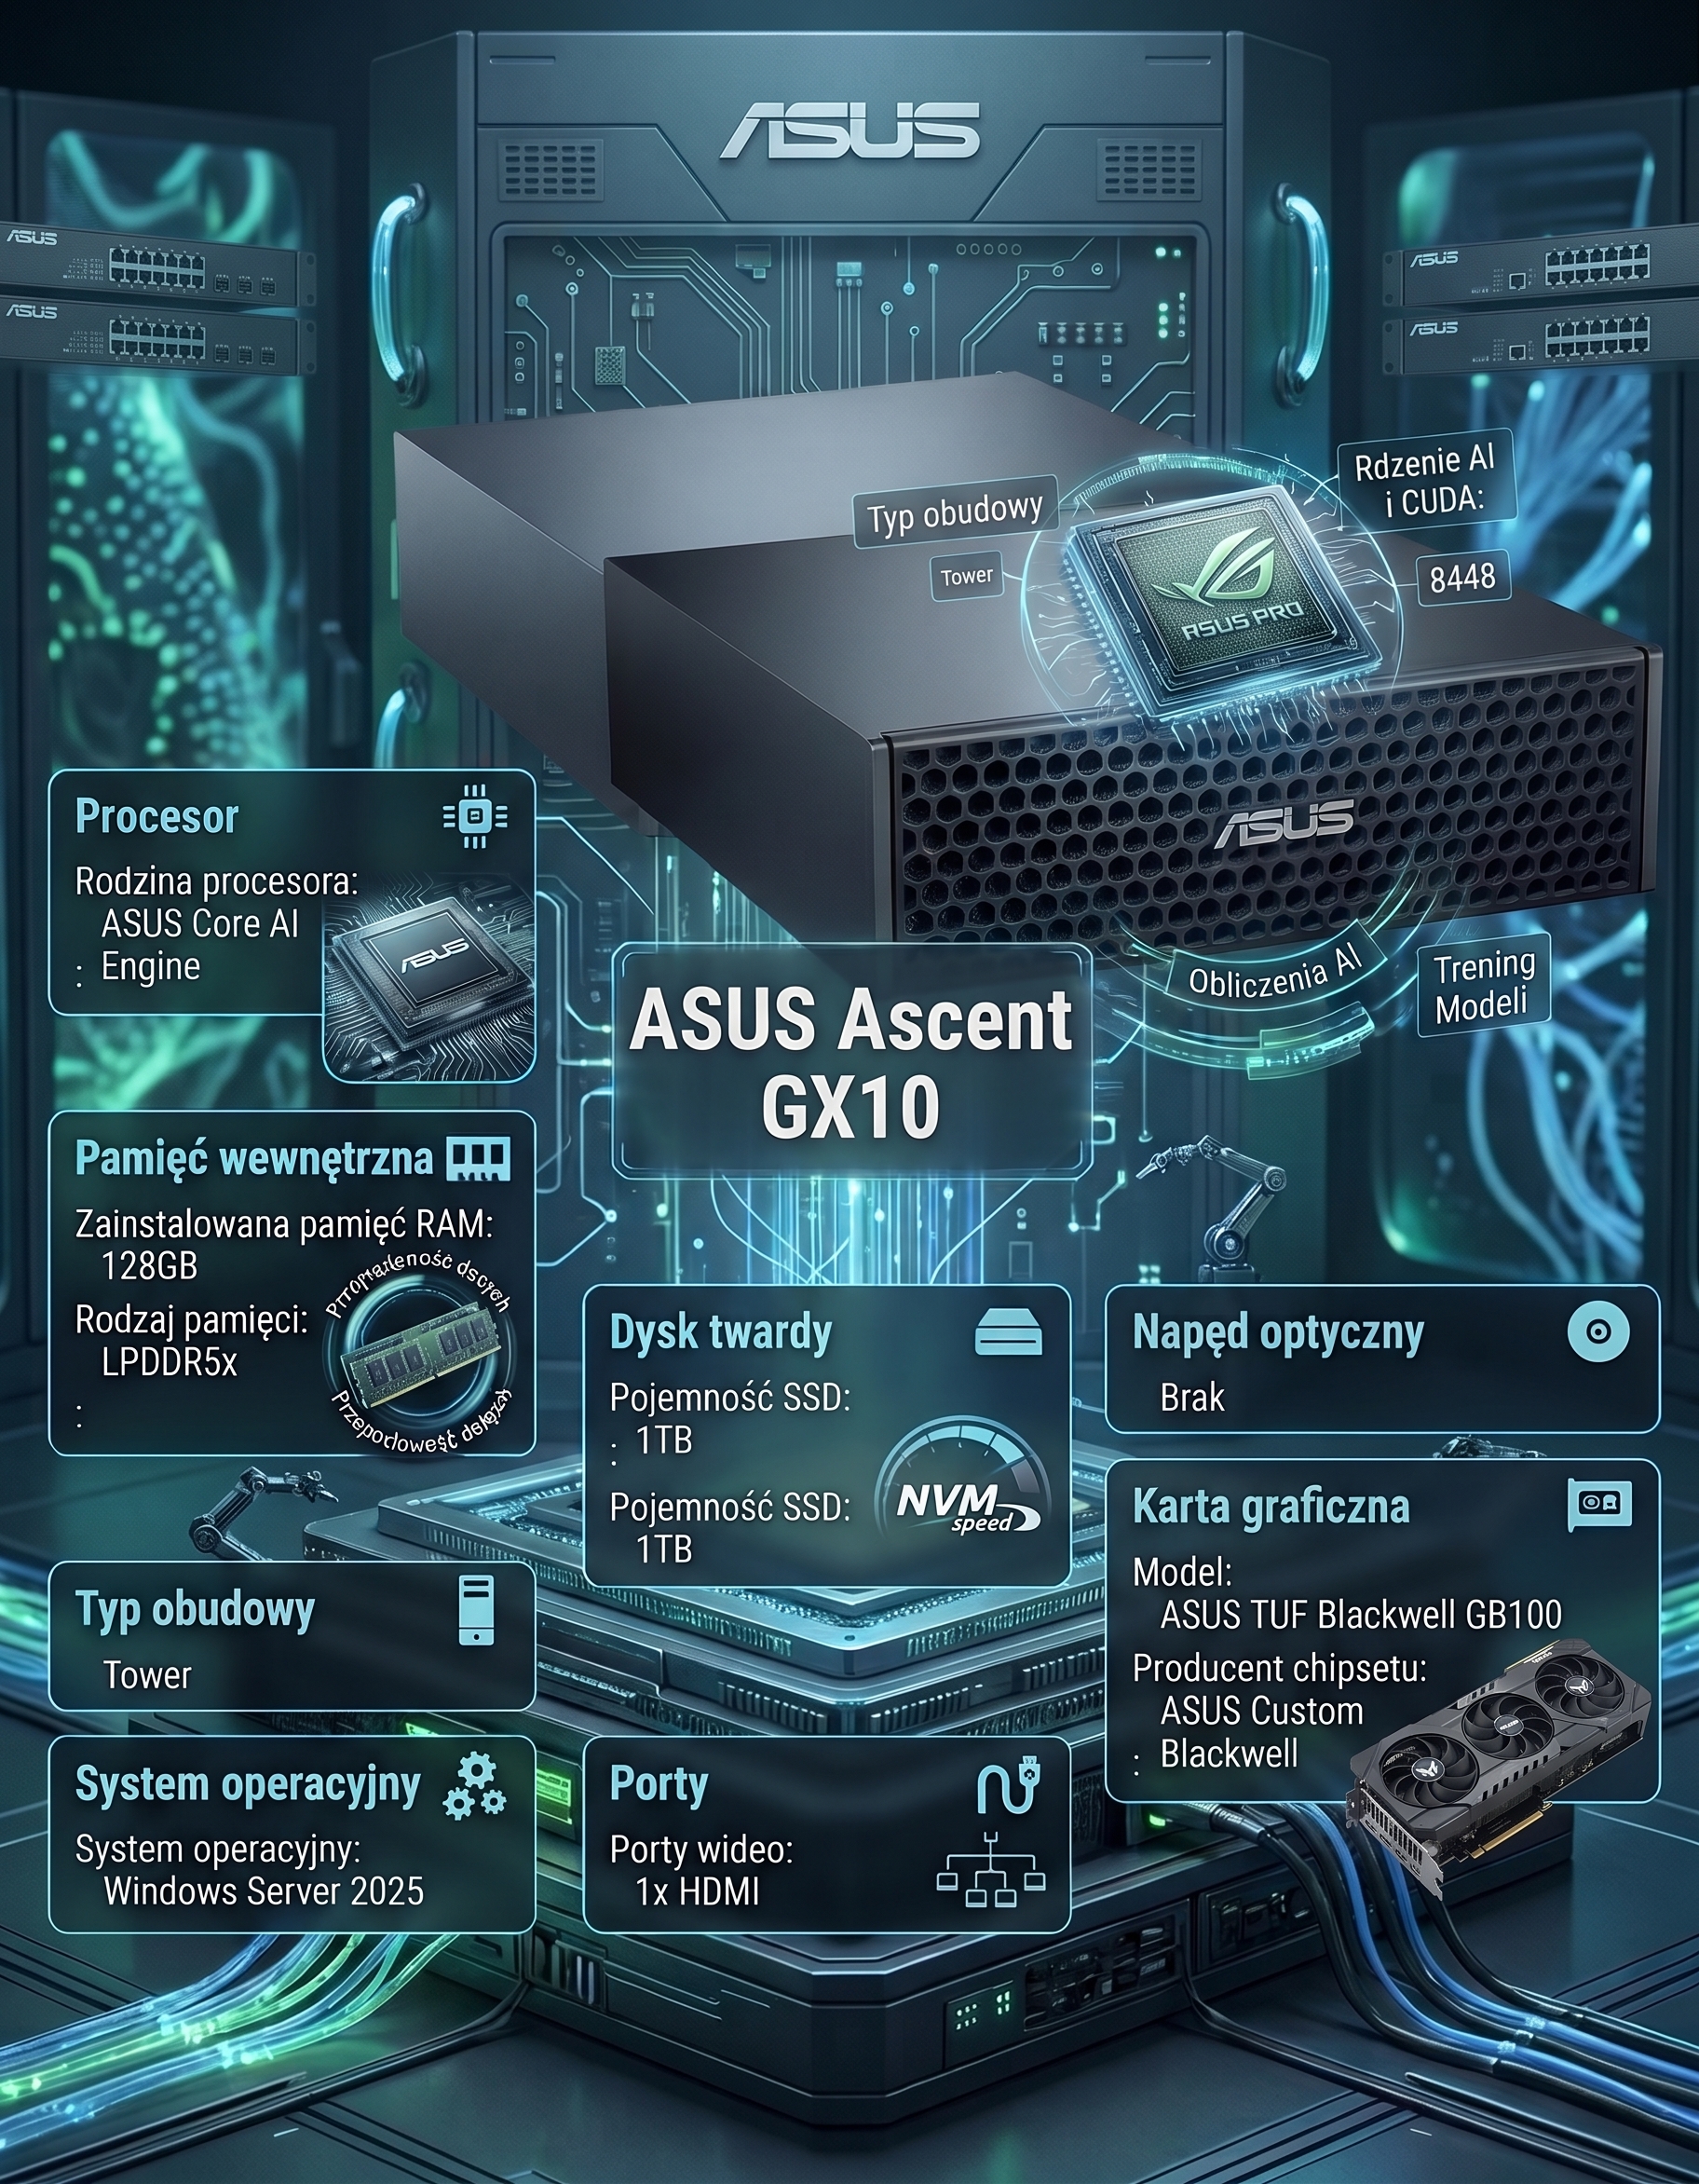
ASUS Ascent GX10

ASUS Ascent GX10

NVIDIA Blackwell GB10 • 128GB RAM • 1TB SSD NVMe

Kompaktowa stacja robocza pod Ubuntu Linux / Windows Server. Architektura chłodzenia zoptymalizowana pod ciągłą inferencję.

Kup samą stację ASUS na Allegro
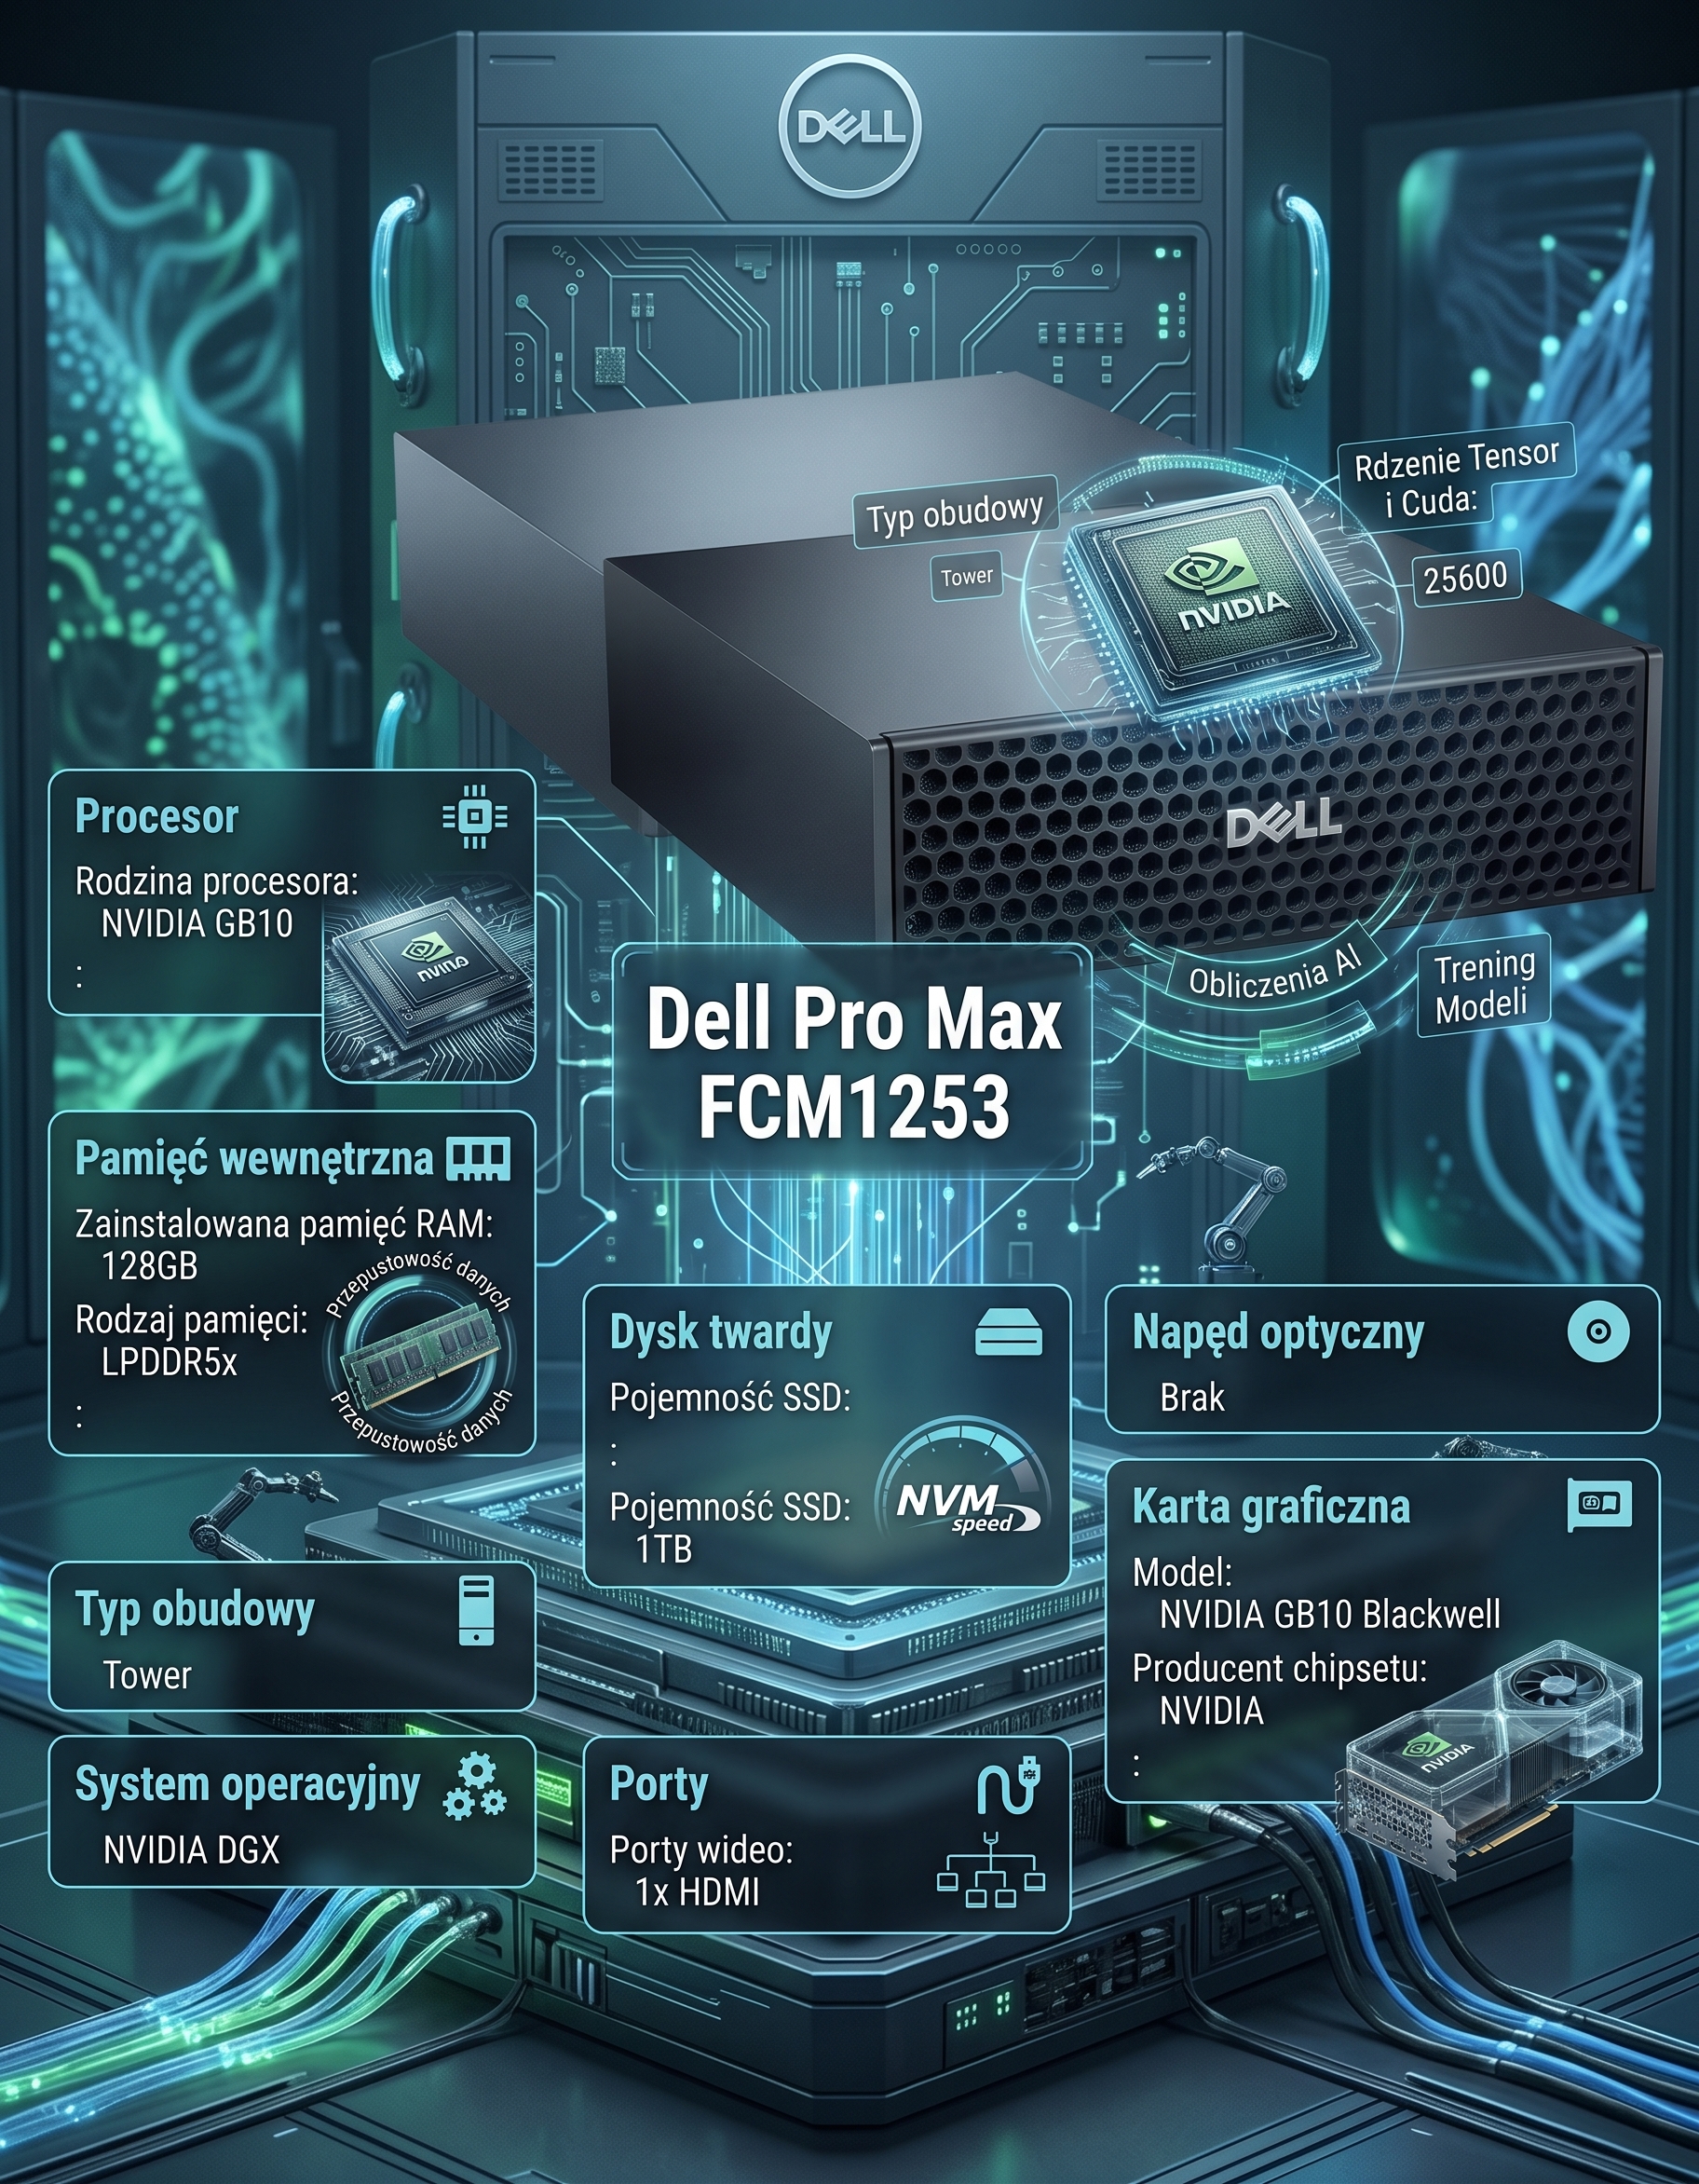
Dell Pro Max FCM1253

Dell Pro Max FCM1253

NVIDIA DGX OS • Grace Blackwell GB10 • 128GB RAM • 1TB SSD

Fabrycznie zintegrowane środowisko DGX OS. Bezpieczeństwo klasy enterprise i pełne wsparcie dla infrastruktury serwerowej.

Kup samą stację Dell na Allegro
Usługa Inżynierska B2B

Pełne Wdrożenie Lokalnej AI w Przedsiębiorstwie

Dostarczamy w pełni autonomiczny, bezpieczny ekosystem AI wewnątrz Twojej sieci intranet. Żadne zapytania ani poufne pliki nie opuszczają stacji roboczej.

Model: Zdalnie (VPN) lub Stacjonarnie (On-site) Rozliczenie: Faktura VAT 23% z protokołem odbioru SLA: 30 dni dedykowanego wsparcia (reakcja do 4h)
01

Etap 1: Audyt i przygotowanie środowiska systemowego

  • Instalacja i optymalizacja OS: Konfiguracja zoptymalizowanego środowiska (Ubuntu Server LTS / Enterprise Linux) pod kątem akceleracji sprzętowej NVIDIA Blackwell.
  • Sterowniki i biblioteki: Instalacja najnowszych sterowników CUDA, cuDNN oraz TensorRT zoptymalizowanych pod architekturę GB10 / RTX 5090.
  • Konfiguracja pamięci masowej: Podział na NVMe (OS, kontenery bazodanowe, środowisko uruchomieniowe) oraz dedykowany magazyn SSD (magazyn modeli Safetensors/GGUF, baza wektorowa i backup).
02

Etap 2: Silnik inferencyjny i dobór modeli LLM

  • Silnik obliczeniowy: Wdrożenie silników inferencyjnych o niskich opóźnieniach (vLLM lub Ollama) w izolowanym środowisku Docker.
  • Modele LLM: Dobór i kalibracja modeli (Llama 3.x, Mistral/Mixtral, Qwen) do zadań analitycznych, finansowych, prawnych i programistycznych.
  • Język polski i Embeddings: Dobór wag ze szczególnym uwzględnieniem precyzji w języku polskim oraz instalacja modeli osadzania (BGE / Nomic) do wyszukiwania semantycznego.
03

Etap 3: Baza wiedzy przedsiębiorstwa (System RAG)

  • Baza wektorowa: Konfiguracja silnika ChromaDB, Qdrant lub pgvector do błyskawicznego przeszukiwania zasobów.
  • Potok indeksowania: Automatyczny pipeline przetwarzający dokumenty firmowe: pliki PDF, DOCX, arkusze kalkulacyjne XLSX, skany, maile, procedury ISO i umowy.
  • Prywatny chatbot: Model odpowiada na pytania pracowników wyłącznie na bazie wewnętrznej dokumentacji, zawsze podając dokładne źródło i numer strony.
04

Etap 4: Interfejs użytkownika i integracja sieciowa

  • WebUI: Intuicyjny interfejs w przeglądarce (Open WebUI) dla całego zespołu pod lokalnym adresem IP lub subdomeną firmową.
  • Role i uprawnienia (RBAC): Izolacja wiedzy – np. dział kadr ma wgląd tylko w teczki HR, a zarząd w umowy strategiczne.
  • Bezpieczeństwo i API: Konfiguracja firewall, lokalne certyfikaty TLS/SSL oraz udostępnienie bramy API zgodnej ze standardem OpenAI (/v1/chat/completions) do spięcia z systemami ERP/CRM.
05

Etap 5: Testy wydajnościowe, warsztat szkoleniowy i dokumentacja

  • Testy obciążeniowe: Pomiary przepustowości (tokens/sec) przy jednoczesnych zapytaniach od wielu pracowników.
  • Warsztat (2–3h): Praktyczne szkolenie dla administratorów IT i kluczowych użytkowników z obsługi bazy RAG i promptingu.
  • Dokumentacja powdrożeniowa: Przekazanie procedur restartu, harmonogramu kopii zapasowych oraz pełnej instrukcji technicznej.
EVENTO Logo

EVENTO

Tomorrow's technologies

Dane Rejestrowe i Siedziba

EVENTO Woźniak Sp. J.
Aleja Brzozowa 46
95-070 Rąbień A.B

NIP: PL7292620195

Tel: 777 070 717

Gwarancja i faktura

Każde wdrożenie oraz zakup sprzętu rozliczany jest pełną fakturą VAT 23% wraz z oficjalnym protokołem zdawczo-odbiorczym.

Wsparcie inżynierskie i wdrożenia B2B

Zamów stację lub konsultację wdrożeniową

Pomożemy dobrać sprzęt, przeprowadzić audyt RAG lub przygotować dedykowaną kalkulację wdrożenia w Państwa infrastrukturze.

Analiza finansowa TCO

Kalkulator Zwrotu z Inwestycji (ROI)

Sprawdź, ile zaoszczędzi Twoja organizacja, zamieniając abonamenty chmurowe (OpenAI/Copilot) na własny mikroserwer AI on-premise.

15 osób
3 stanowiska 50 stanowisk 100 stanowisk
120 PLN
80 PLN (~$20 Plan bazowy) 250 PLN (Copilot/Team) 400 PLN (Duże API)
Prognoza oszczędności netto
Roczne wydatki na chmurę: 21 600 PLN
Roczny koszt energii stacji (średnio ~150W): ~1 050 PLN
Roczna oszczędność z lokalnym AI: 20 550 PLN
Szacowany czas pełnego zwrotu z zakupu: ok. 21 miesięcy